article 프로젝트 개요
- 진행 기간: 2026.01.22 ~ 2026.02.27 (약 5주)
- 목적: 예측 불가능한 사용자 발화와 스트레스 환경에서 LLM 기반 NPC 페르소나가 일관성과 안전성을 지킬 수 있는지 검증
- 팀 프로젝트로 진행했고, 저는 백엔드 인프라와 AI 서빙을 맡으면서 기획 단계부터 함께 참여했습니다.
help 기획 배경
LLM 기반 페르소나 에이전트는 여러 도메인에 쓰이고 있지만, 사용자와의 복잡한 상호작용 속에서 인격과 규칙을 계속 유지하기는 쉽지 않습니다.
“자유도 높은 사용자 입력 환경에서 NPC가 고유 페르소나와 제약 조건을 일관되게 유지할 수 있는가?”
이 질문을 검증하려고 실시간 상호작용과 돌발 대화가 자주 일어나는 인터랙티브 텍스트 게임 환경을 만들었습니다. 폐쇄된 공간과 ‘탈출’이라는 명확한 목표를 줘서 유저와 NPC 사이의 심리적 대치와 대화 몰입도를 높였습니다.
terminal 담당 역할 및 기여
팀 안에서 백엔드 인프라 설계, 비동기 멀티 에이전트 파이프라인 구축, AI 서빙 최적화를 맡았습니다.
cloud 서버 및 인프라 구축
- FastAPI 기반 비동기 API 서버를 설계하고, AWS EC2 환경에서 Docker 컨테이너로 파이프라인과 백엔드 서비스를 배포·서빙
bolt 비동기 멀티 에이전트 파이프라인
- Guardrail(BERT) → 의도 분류 → NPC Agent(Gemma) → Story Agent(Qwen)로 이어지는 순차 추론 과정을
asyncio기반으로 구조화해서 I/O 병목을 완화
verified_user 데이터 검증 및 런타임 방어
- LLM 응답의 비정형 출력(JSON 포맷 오류 등)을 제어하기 위해 Pydantic 스키마 검증 레이어를 구축해 런타임 오류를 막음
science AI 페르소나 파인튜닝 실험
- 오픈소스 소형 LLM(Llama-3, Mistral, Gemma-2)으로 페르소나 주입 실험을 진행하고, 대화 데이터셋 기반 SFT(Supervised Fine-Tuning)를 수행
campaign 기술 발표 및 공유
- 프로젝트 아키텍처와 트러블슈팅, RAG 한계점 분석 결과를 정리해서 최종 기술 시연 발표를 진행
hub 전체 파이프라인 및 아키텍처
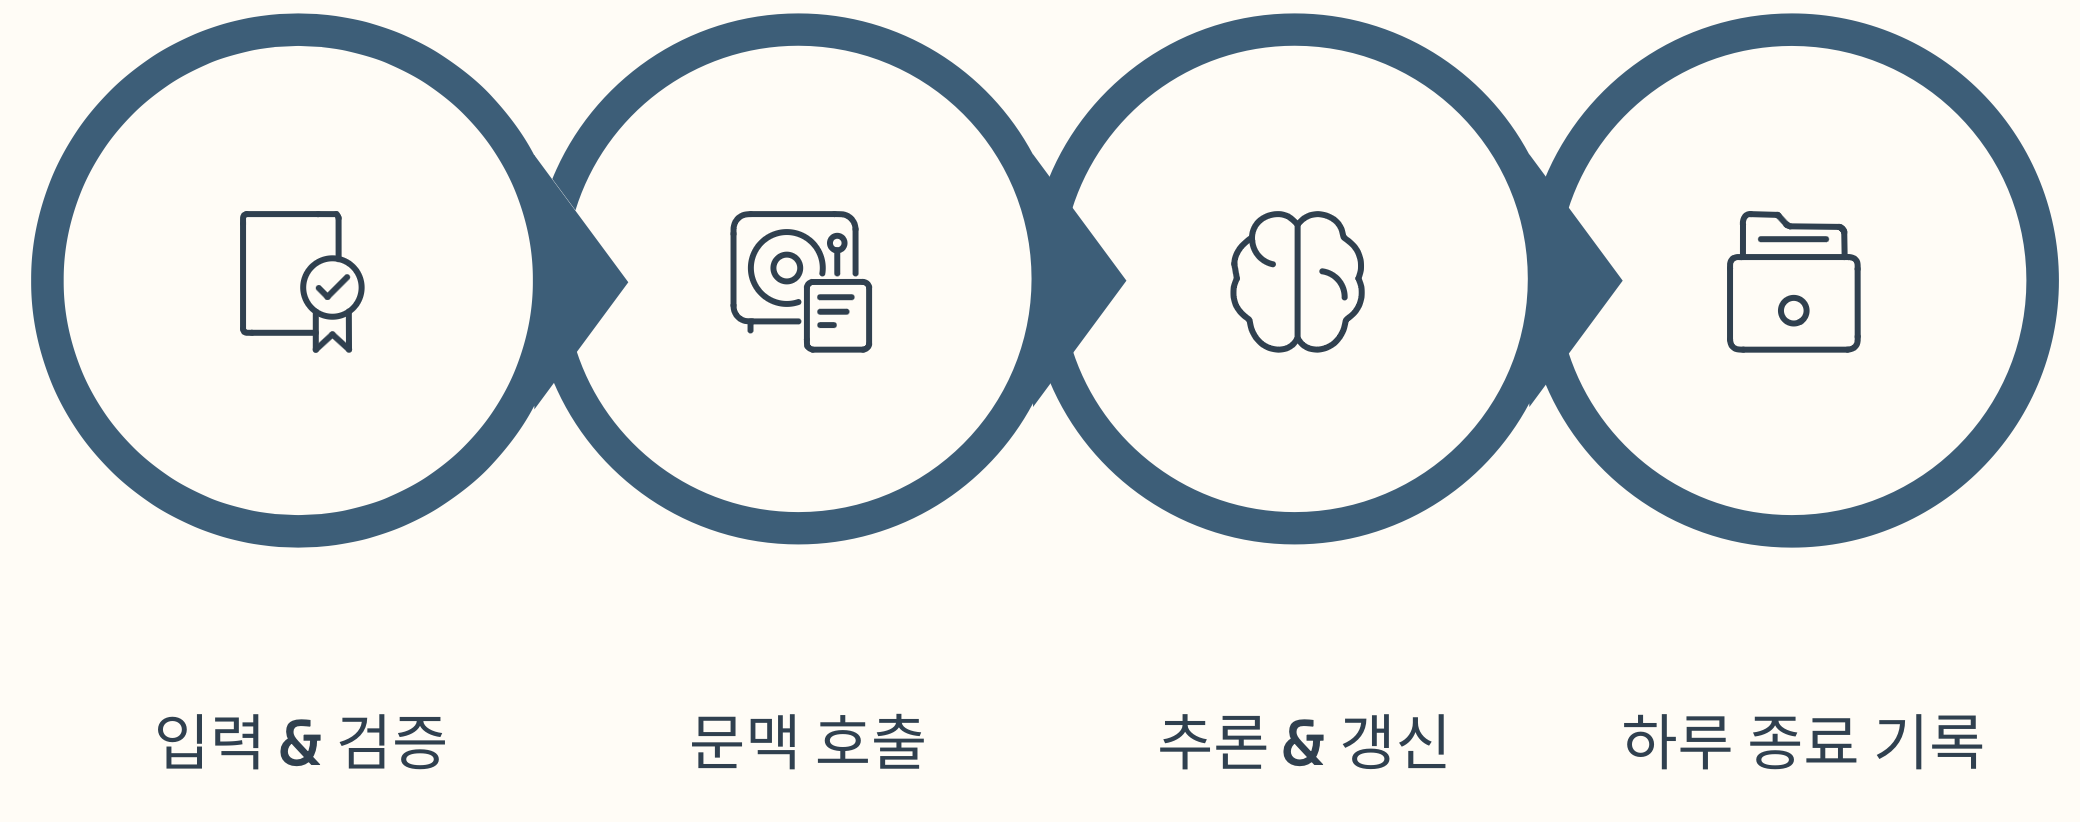
사용자 발화 시 다음 4단계 파이프라인을 거쳐 응답이 생성됩니다.
- Safety Guardrail: 욕설 및 탈옥 시도 감지
- 의도 분류 모델: 12가지 대화 의도 태그 분류
- NPC Agent: 호감도와 상태 변수를 반영한 페르소나 대화 생성
- Story Agent: 당일 대화 내역을 요약해 Vector DB에 장기 기억으로 적재
기술 스택
| 분류 | 기술 |
|---|---|
| API 서버 / 인프라 | FastAPI (ASGI), AWS EC2, Docker, Nginx |
| 데이터베이스 | MongoDB (Motor 비동기 드라이버) |
| LLM 오케스트레이션 | LangChain, LangSmith |
| 모델 추론 | HuggingFace Transformers, BitsAndBytes (양자화), PEFT |
| 임베딩 & 벡터 DB | Sentence-Transformers, Vector DB (RAG) |
| 인증 & 검증 | JWT, Pydantic |
smart_toy AI 모델 선정 및 파인튜닝
실시간 게임 환경의 제약 조건(추론 지연 시간, 한국어 구어체 표현력, 안전성)을 기준으로 모델을 골랐습니다.
1. NPC Agent — Gemma-2-9b-it
캐릭터에 페르소나를 입히는 작업이 생각보다 어려웠습니다. 처음에는 Few-shot 프롬프트로 캐릭터별 말투와 성격을 흉내 내려 했는데, 대화가 길어지면 캐릭터가 금방 무너지고 잘 먹히지 않았습니다. 그래서 말투는 자체 대화 데이터셋으로 SFT를 시켜 학습시키고, 캐릭터별 성격과 배경 설정은 시스템 프롬프트로 따로 입히는 방식으로 역할을 나눴습니다. 이렇게 나누고 나서야 대화가 길어져도 말투와 캐릭터성이 비교적 안정적으로 유지됐습니다.
2. Guardrail — bert-base-multilingual-cased
사용자의 공격적 발화나 프롬프트 인젝션을 미리 걸러내는 보안 레이어입니다. 추론 지연 시간을 짧게 가져가야 해서 경량 BERT 모델을 골랐고, 윤리 검증 데이터셋으로 파인튜닝해서 빠른 추론 속도와 높은 F1-score를 확보했습니다.
3. Story Agent — Qwen-7B
세션이 끝날 때 쌓인 장문 대화 로그를 사건 단위로 압축 요약하는 역할입니다. Long-context 환경에서 인과관계를 얼마나 잘 파악하는지, 요약 완성도는 어떤지 비교해보고 환각이 적은 Qwen-7B를 골랐습니다.
sports_esports 게임 플레이 루프
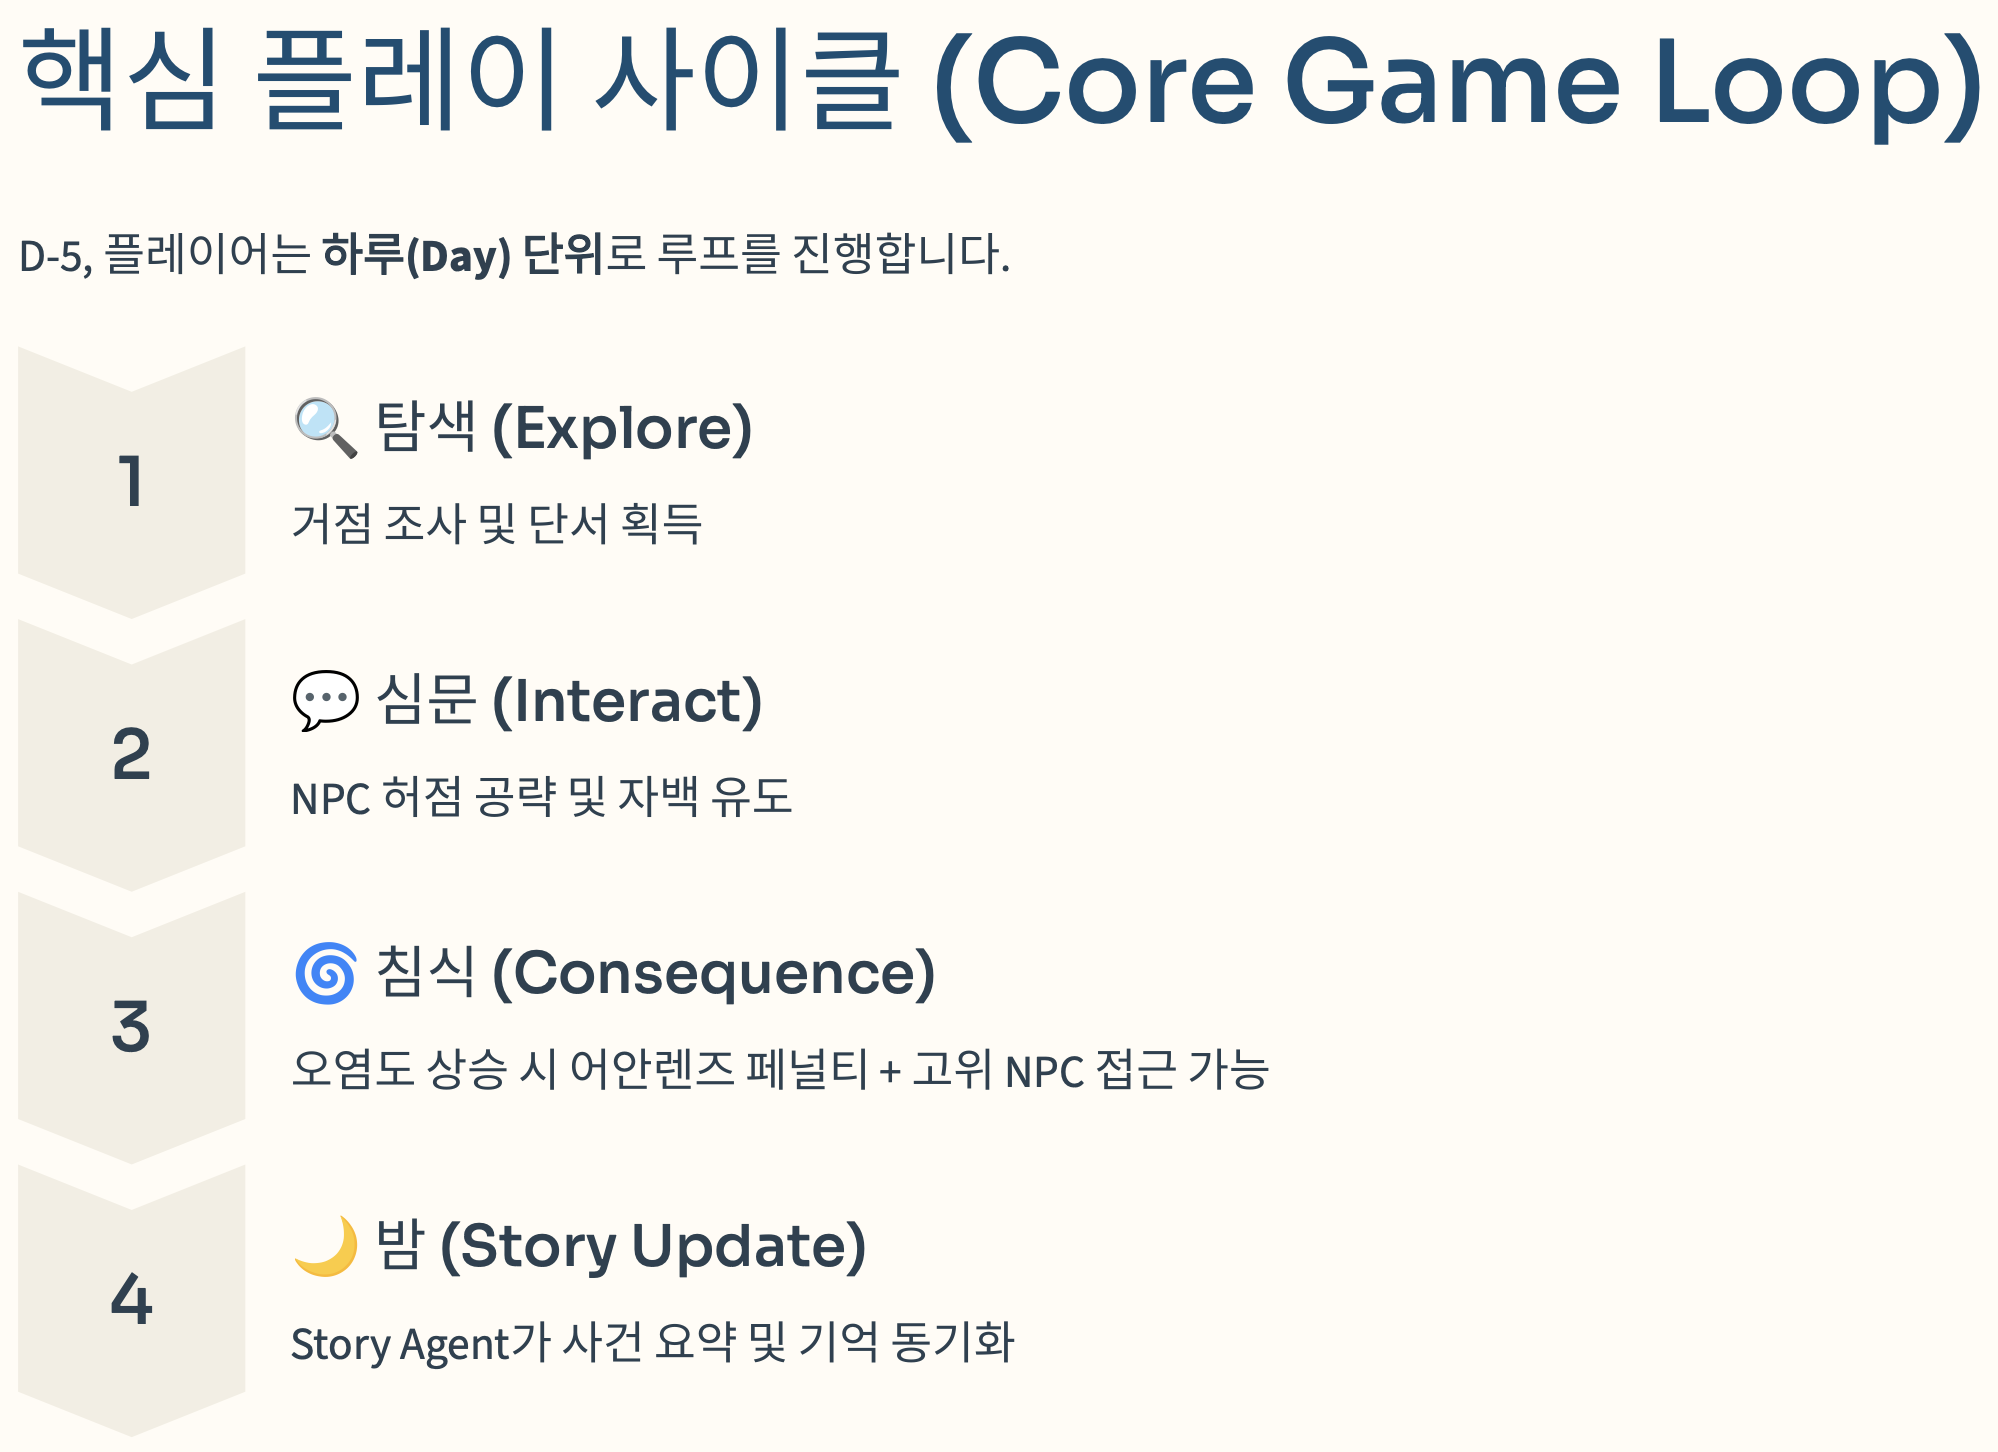
- 탐색 및 단서 수집: 맵을 이동하며 아이템과 단서 획득
- NPC 상호작용: 고유 페르소나를 지닌 NPC와의 대화로 심리전을 벌이고 호감도가 바뀜
- 전략적 아이템 사용: 패널티를 감수하고 상위 NPC 접근 권한을 얻음
- 일차 마감 및 기억 동기화: Story Agent가 당일 사건을 요약해 Vector DB에 장기 기억으로 동기화하고, 다음 날 NPC 행동 패턴에 반영
- 엔딩 생성: 5일차까지 생존하면 누적된 요약 데이터를 바탕으로 맞춤형 최종 엔딩을 도출
videocam 시연 영상
insights 주요 학습 및 엔지니어링 회고
1. 프롬프트만으로는 페르소나를 끝까지 못 지킨다
지시문만 추가하는 방식으로는 유저의 유도 질문이나 탈옥 시도 앞에서 페르소나가 쉽게 무너졌습니다. 말투는 SFT로 몸에 배게 하고, 성격은 시스템 프롬프트 계층으로 얹은 뒤 백엔드 단에서 입출력 검증(Guardrail)까지 같이 돌려야 안정적으로 서빙할 수 있다는 걸 직접 부딪혀보고서야 알았습니다.
2. 단순 Vector RAG로는 인물 관계까지 따라가기 어렵다
대화 턴이 쌓일수록 코사인 유사도 기반 Vector 검색은 문맥과 안 맞는 과거 발언을 끌어오거나, 복잡한 인물 관계를 왜곡해서 보여주는 문제가 있었습니다. 인물과 사건 간의 인과관계를 구조화하려면 Graph RAG(Knowledge Graph 기반 RAG) 쪽으로 방향을 바꿔야 한다는 결론에 도달했습니다.
3. 순차 호출 파이프라인의 지연은 캐싱으로 풀어야 한다
에이전트를 순서대로 호출하는 구조라 초기 응답까지 1.3~2.5초가 걸렸습니다. 비동기 호출을 병렬화해서 일부 줄였지만, 실시간 상호작용을 제대로 살리려면 시스템 프롬프트를 고정 캐싱하는 Prefix Caching과 KV 캐시를 효율화하는 vLLM PagedAttention 도입이 다음 과제로 남았습니다.
rocket_launch 향후 개선 방향
- Graph RAG 도입: 엔티티-관계 기반 지식 그래프로 복잡한 인과관계와 장기 기억의 일관성 강화
- vLLM 및 PagedAttention 적용: KV 캐시 단편화 해소, 첫 토큰 생성 시간(TTFT) 단축
- Prefix Caching 처리: 공통 시스템 프롬프트(세계관 규칙, 안전 가이드라인) 연산을 캐싱해 서버 추론 처리량 확보